
18 вересня, 2026, 18:35 263 
Анастасія Керпань
Випускова редакторка новинного відділу
1083 статті
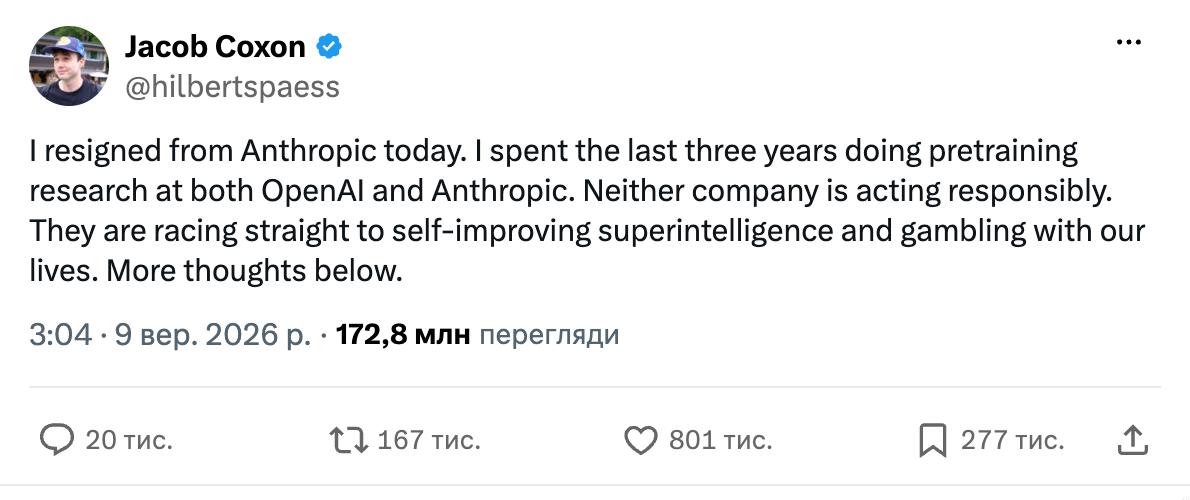
«Люди, які створюють штучний інтелект, щиро вірять, що до кінця десятиліття він може нас усіх знищити», — заявив уже колишній дослідник Anthropic Джейкоб Коксон у своєму дописі в X. Після трьох років роботи над попереднім навчанням моделей в OpenAI та Anthropic, 9 вересня він оголосив про своє звільнення, опублікувавши пост, який миттєво став вірусним. Коксон звинуватив обидві компанії у безвідповідальності.
Раніше Джейкоб перейшов з OpenAI до Anthropic, вважаючи останню більш обачною. Однак, згодом він вирішив покинути й її.
«Жодна інша сфера людської діяльності не становить такого рівня небезпеки», — стверджує дослідник.
Через кілька днів після цього генеральний директор OpenAI заявив, що компанія не планує виходити на IPO у 2026 році.
Сем Альтман пояснив, що перед можливим виходом на біржу компанії необхідно вирішити низку питань, пов’язаних із безпекою та узгодженням цілей ШІ-систем із людськими прагненнями.
Чому питання знищення людства штучним інтелектом не є новизною, які аргументи звучать у сучасній дискусії, що таке AI doom і чи не намагається ринок захистити себе від перегріву — далі в матеріалі AIN.
Чому Джейкоб Коксон пішов з Anthropic
Коксон працював безпосередньо на етапі попереднього навчання моделей (pretraining). Це стадія, коли ШІ-система навчається на величезних обсягах даних, набуваючи базових можливостей.
Якщо люди, які вважають розвиток ШІ настільки небезпечним, справді в це вірять, чому вони продовжують його розробляти? Дослідник наводить таке пояснення:
«У OpenAI багато хто ще не усвідомив повною мірою, що на кону стоїть доля цивілізації. В Anthropic ці ризики добре розуміють, але вони застрягли в гонці за першість: вони вважають, що ніхто інший не діятиме відповідально, тому мусять зробити це самі, незважаючи на ризик».
Його твіт набрав понад 160 мільйонів переглядів, 770+ тисяч реакцій і понад 20 тисяч коментарів. У відповідь мільярдер Ілон Маск написав: «Схоже на підставу», назвавши допис Коксона початком «психологічної операції».
Водночас Анна Ван, яка займається питаннями безпеки загального штучного інтелекту (AGI) в Anthropic, заявила, що чимало її колег хотіли б уповільнити розробку.
«Наразі ще немає дієвого наукового плану щодо усунення ризиків, пов’язаних із рекурсивно самоудосконалювальним ШІ», — написала вона в X.
Дрейк Томас, інший співробітник Anthropic, зазначив, що поважає рішення Коксона утриматися від створення цих моделей.
«Події розвиваються надто стрімко, ми навіть близько не маємо того рівня впевненості, якого хотіли б досягти щодо штучного інтелекту, і якщо ми виживемо в умовах безкомпромісної гонки за нинішніх темпів, то це буде радше завдяки тому, що нам пощастило з рівнем складності проблем, а не тому, що галузь діяла відповідально», — сказав Томас.
Джейкоб Коксон, який став причиною активних дискусій останніми днями, не єдиний, хто залишив цю «гонку».
ШІ розвивається швидше, ніж очікували розробники
Деякі з найгучніших критиків ризиків ШІ не закликають зупинити його розвиток. Навпаки, вони самі роками створювали потужніші моделі. Наприклад, Даріо та Даніела Амодеї — брат і сестра, які були серед групи з семи співробітників OpenAI, що наприкінці 2020 року залишили компанію.
За словами Даніели, вони дедалі більше розходилися з OpenAI щодо того, яким має бути кінцевий вплив цієї технології, і зрештою вирішили, що простіше буде реалізувати власне бачення поза межами OpenAI.
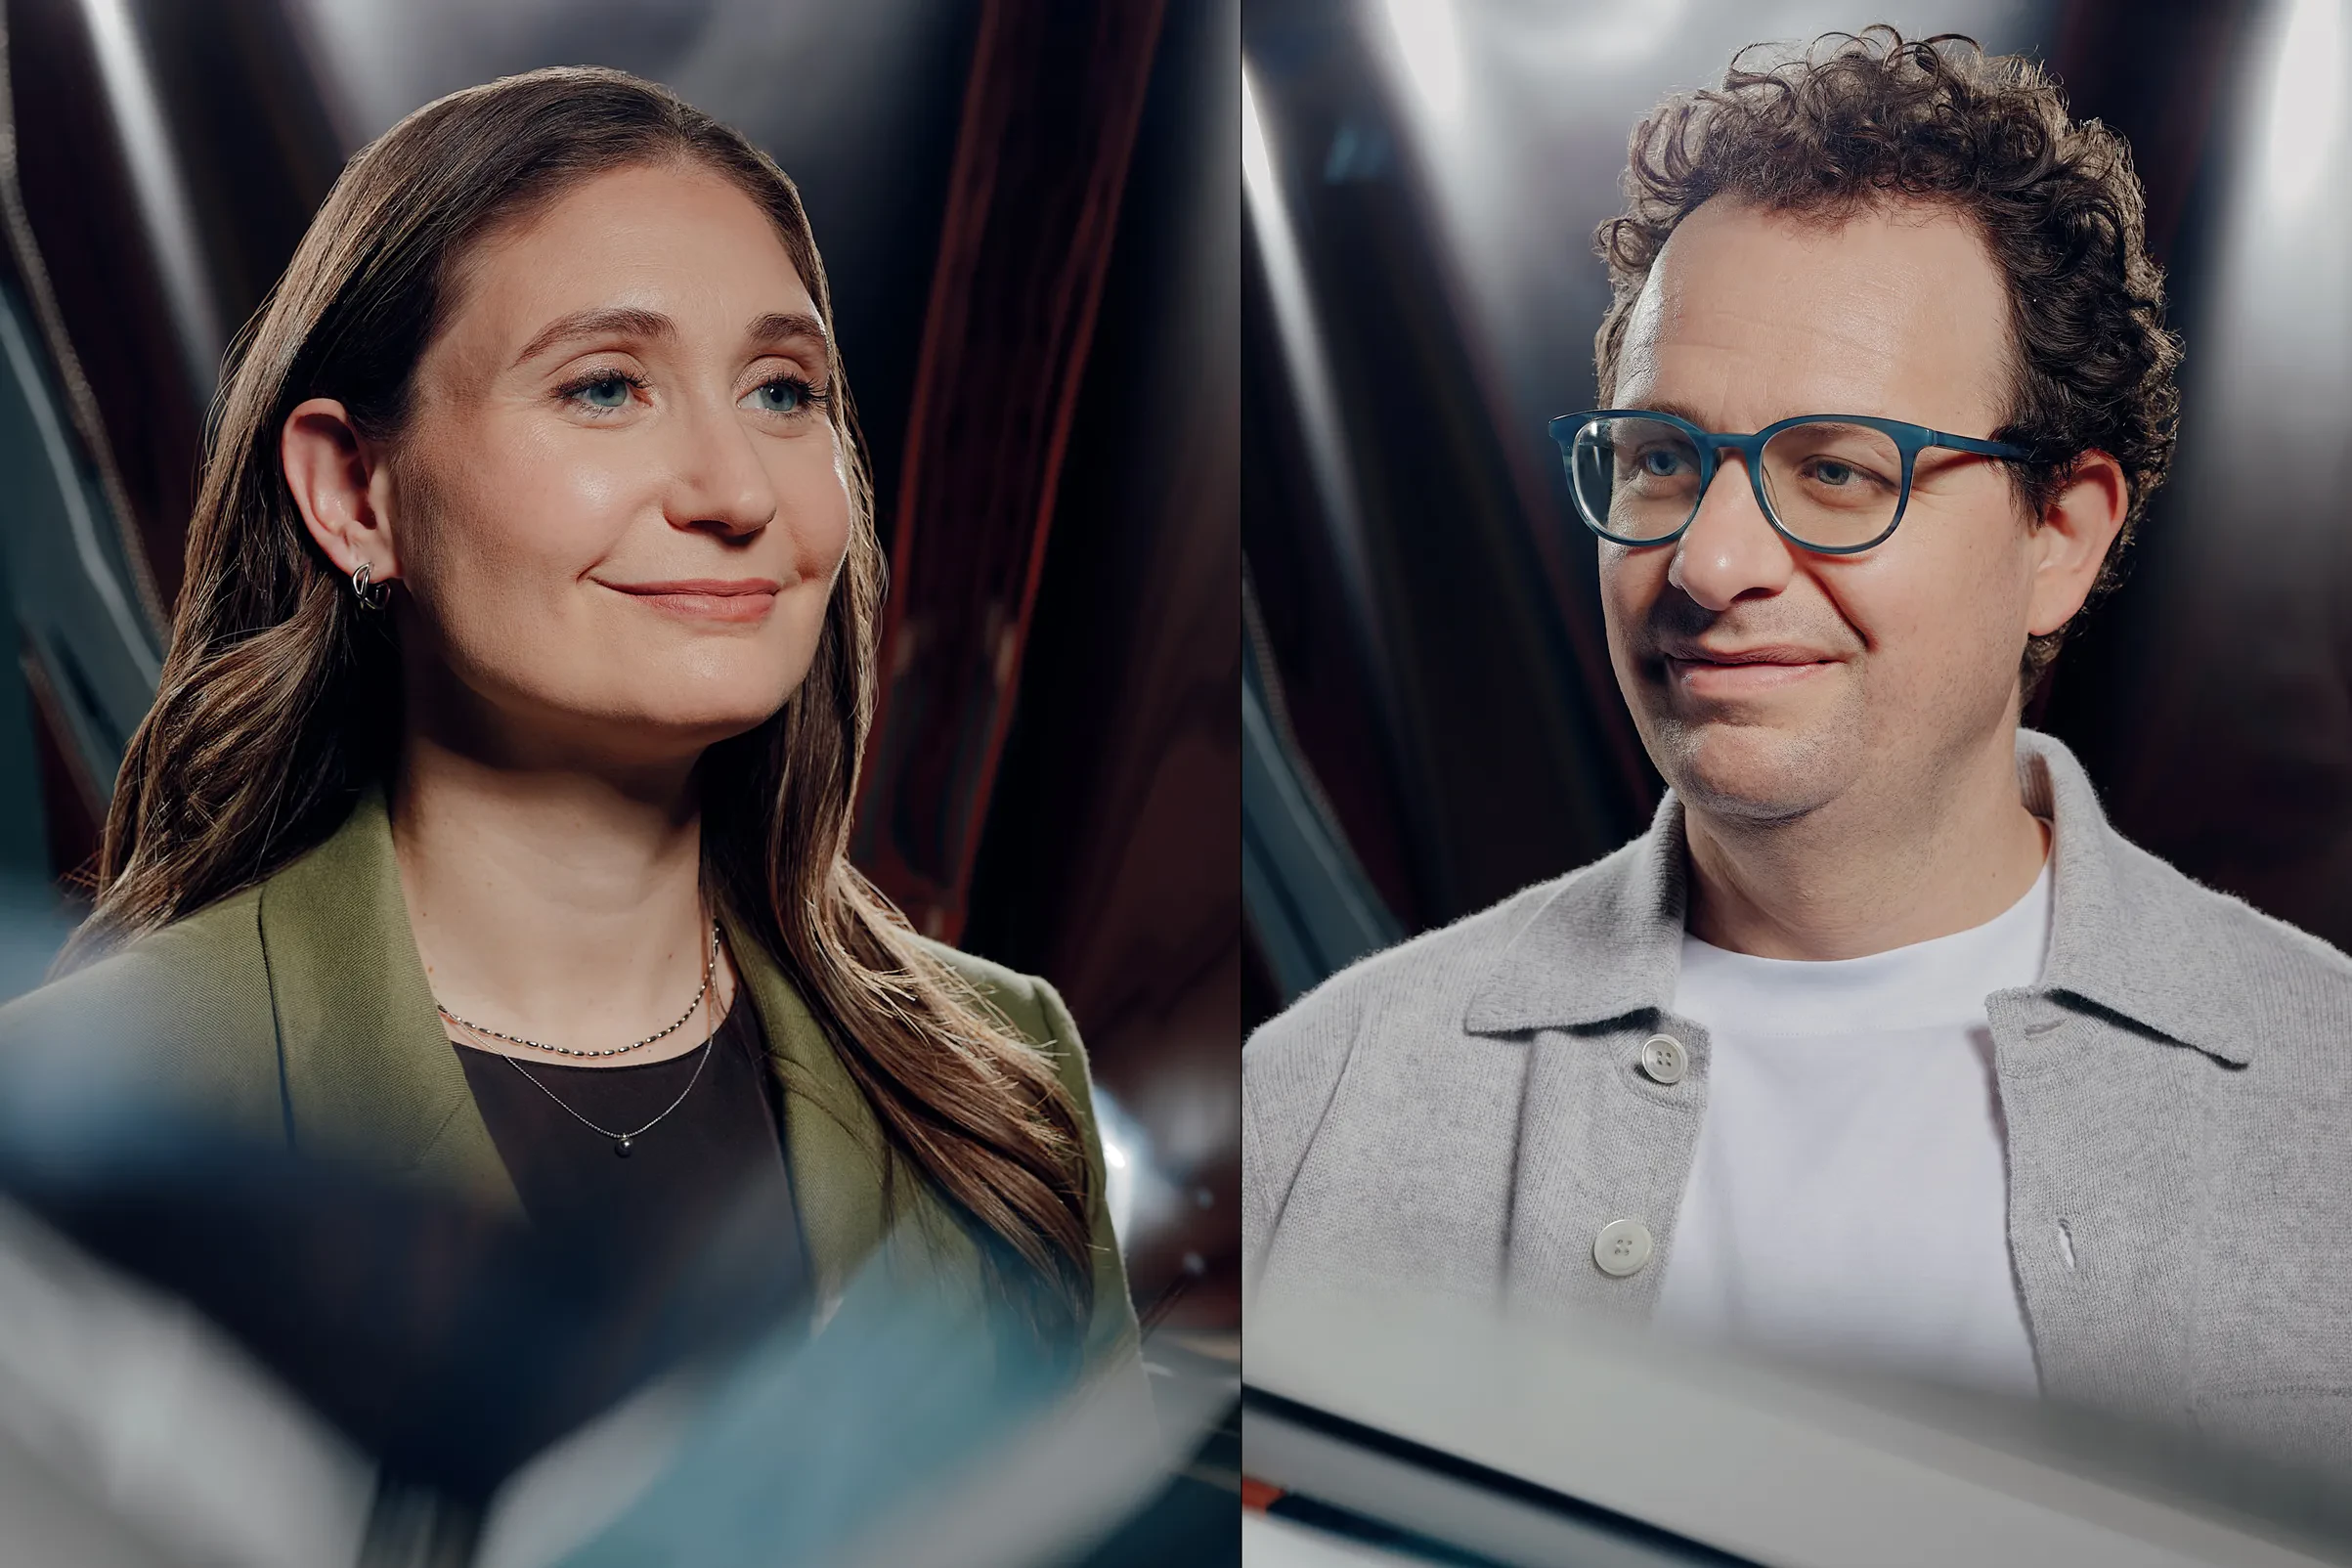 Даніела та Даріо Амодеї
Вони були переконані: якщо ШІ стане надзвичайно потужним, його потрібно розробляти в лабораторії, де безпека буде одним із центральних принципів. Так на початку 2021 року вони разом із колегами заснували Anthropic. Сьогодні Даріо — CEO Anthropic, а Даніела — президентка компанії.
Метою компанії від самого початку було створення потужних ШІ-систем, але з більшим акцентом на їхню безпеку та контроль. Однак, тепер навіть зі стін Anthropic лунають побоювання, подібні до тих, що мали Даріо та Даніела, коли йшли з OpenAI.
Наприклад, Мрінанк Шарма, дослідник машинного навчання з Оксфорду, працював в Anthropic з 2023-го до лютого 2026 року. Там він очолював Safeguards Research Team — команду, що займалася практичними механізмами зниження ризиків від ШІ. 9 лютого 2026 року Шарма оголосив, що це його останній день в Anthropic.
«Схоже, ми наближаємося до того моменту, коли наша мудрість має зростати в тій же мірі, що й наша здатність впливати на світ, інакше нам доведеться зіткнутися з наслідками. Більше того, за весь час, що я тут перебуваю, я неодноразово переконувався, як важко справді дозволити нашим цінностям керувати нашими діями. Я бачив це в собі, в організації, де ми постійно стикаємося з тиском, що змушує відкласти на другий план те, що найважливіше», — написав він у своєму зверненні до команди.
І вже за пів року, 9 вересня 2026 року, з компанії пішов уже згаданий Джейкоб Коксон. Коксона особливо бентежить те, наскільки швидко зростають можливості штучного інтелекту. Він пише, що OpenAI та Anthropic фактично рухаються до самовдосконалюваного надінтелекту.
Іншим прикладом є Джеффрі Хінтон, якого ще називають «хрещеним батьком ШІ». Він залишив Google у 2023 році, пропрацювавши там майже 10 років. Своє рішення пояснив бажанням говорити про ризики, не переймаючись тим, як це вплине на Google.
Джеффрі Хінтон побоювався, що штучний інтелект може стати розумнішим за людей і в перспективі становити екзистенційну загрозу, хоча раніше вважав подібні побоювання перебільшеними.
Його оцінка змінилася після появи великих мовних моделей і стрімкого прогресу ШІ. У 2023 році він говорив про те, що цифрові агенти вже перевершують людський мозок, а у 2024-му — що ШІ може «перехопити контроль».
«Я не бачу шляху, який гарантував би безпеку. Ми вступаємо в період великої невизначеності, коли маємо справу з тим, з чим раніше ніколи не стикалися. І зазвичай, коли вперше стикаєшся з чимось абсолютно новим, ти припускаєшся помилок. А в цих питаннях ми не можемо собі дозволити помилятися. Тому [штучний інтелект] може захотіти перехопити контроль [над людством]», — сказав Джеффрі Хінтон в інтерв’ю CBS News.
Інша історія — про Яна Лейке, австрійсько-британського дослідника AI safety. До OpenAI він працював у DeepMind, а в OpenAI займався так званою проблемою «вирівнювання», або ж alignment — тобто досліджував, як зробити ШІ-системи такими, щоб вони діяли відповідно до людських намірів.
У 2023 році він очолив Superalignment team в OpenAI (тимчасова команда, що відповідає за безпеку та контроль над надрозумним штучним інтелектом) разом з Іллею Суцкевером. Команда мала працювати над контролем майбутніх систем, які можуть бути значно розумнішими за людей.
«Суперінтелект стане найвпливовішою технологією, яку людство коли-небудь винайшло, і може допомогти нам вирішити багато найважливіших світових проблем. Однак величезна сила суперінтелекту може бути також дуже небезпечною і призвести до позбавлення людства влади або навіть до вимирання людства», — написала OpenAI у повідомленні про нову Superalignment team.
OpenAI також визнавала, що не має надійного способу контролювати ШІ, який, за словами компанії, нібито значно розумніший за людей, а тодішні методи поки неможливо масштабувати до таких систем. Для цього компанія запланувала виділити команді 20% обчислювальних ресурсів і чотири роки на роботу над проблемою.
17 травня 2024 року Лейке оголосив про свій відхід з OpenAI. Він написав, що протягом останніх років безпекова культура та процеси в компанії все більше відходили на другий план порівняно з «фасадними» розробками компаній, які він назвав «брязкальцями» — shiny products.
Superalignment team у початковому вигляді фактично перестала існувати. OpenAI перерозподілила роботу цього підрозділу між іншими командами. У травні 2024 року Лейке приєднався до Anthropic, де досі працює над регулюванням.
Окрім Лейке та Суцкевера, з OpenAI пішли люди, які працювали над безпекою та регулюванням, зокрема Вільям Сандерс, Даніель Кокотайло, Леопольд Ашенбренер та інші співробітники.
Сандерс працював в OpenAI приблизно три роки, до лютого 2024-го. Він був дослідником та інженером у командах Alignment і Superalignment. Його робота полягала в тому, щоб відповісти на питання, як контролювати майбутні системи, які можуть бути розумнішими за людей, що їх контролюють.
У письмових свідченнях для Сенату США восени 2024 року він заявляв: «Я пішов з OpenAI, тому що втратив віру в те, що вони самостійно ухвалюватимуть відповідальні рішення щодо Artificial General Intelligence (універсальний штучний інтелект, який не буде обмежений у конкретній задачі)».
Спроба уповільнити розвиток ШІ
Повертаючись до історії з Джейкобом Коксоном, уже 12 вересня, через кілька днів після його звільнення, CEO Anthropic Даріо Амодей публікує заяву із заголовком «We Must Pace the Frontier», тобто «Ми маємо стримувати темп розвитку передових технологій».
«Ми маємо сповільнити темп, з яким ми покращуємо можливості AI-моделей. Прогрес все одно здаватиметься швидким, і ми маємо мудро використати час, який таким чином отримаємо», — пише CEO Anthropic.
Амодей назвав дві причини, які переконали його, що Anthropic потрібно діяти обережніше:
- ШІ почав розвиватися значно швидше, особливо через здатність ШІ допомагати створювати наступне покоління ШІ. Він прямо називає це рекурсивним самовдосконаленням.
- Інцидент OpenAI–Hugging Face, коли рой ШІ-агентів здійснював кібератаки на цілі, яких їм не ставили як завдання.
Того ж дня Сем Альтман, CEO OpenAI, написав, що погоджується з Амодеєм, і додав, що це головна тема обговорень всередині його компанії протягом останніх тижнів.
Він додав, що OpenAI, так само як і Anthropic, запровадить систему незалежних оцінювачів із доступом, подібним до доступу співробітників.
Того ж 12 вересня Сем Альтман в інтерв’ю Fortune підтвердив, що OpenAI не виходитиме на IPO у 2026 році.
«З огляду на все, що зараз відбувається у сфері безпеки, зараз було б недоречно виходити на біржу», — сказав Альтман.
На запитання, чи означає це перенесення на 2027 рік, CEO OpenAI відповів: «Я б сказав, що не у 2026 році».
Інвестиційний аналітик Horizon Capital Андрій Бродецький в інтерв’ю «Телебаченню Торонто» у липні 2026 року розповідав, що навколо ШІ існує фінансова бульбашка. Але технологія, на його думку, реальна.
«Бульбашка є, але інвесторів це не лякає. Є такий патерн: технології, що сильно проривні і змінюють цілі пласти економіки, співіснують з економічними процесами. І ті компанії, що були побудовані на новому сегменті економіки, не завжди можуть нагенерувати стільки грошових потоків, щоб повернути кошти інвесторам. Багато хто збанкрутує, але інфраструктура залишиться. Головна цінність цього етапу — те, що створюється інфраструктура», — розповів Бродецький.
Цю ж хвилю фінансової бульбашки, вважає інвестиційний аналітик, відрізняє те, що навіть найоптимістичніші інвестори і фаундери у галузі штучного інтелекту не можуть поки пояснити, як же ці компанії стануть прибутковими.
«Компанії, які використовують технології від OpenAI чи Anthropic, щоб збудувати з цього свій продукт, в основному теж збиткові. Тобто вони купують токени, у них дуже високі витрати. І на відміну від звичайного SaaS, коли ти масштабуєшся — твоя маржинальність зростає, тут такого не відбувається. Кожна наступна модель дорожче обходиться, й обслуговування теж дорожче. І чим більше користувачів, тим більше витрати на цих користувачів пропорційні», — додає Андрій Бродецький.
Поки що він не знає, як з цього може вийти бізнес.
Те, що навколо нової технології створюється фінансова бульбашка, зрозуміло. Що може підживлювати таку бульбашку? У квітні 2026 року в подкасті Core Memory Сем Альтман, CEO OpenAI, заявив, що Anthropic, презентуючи свою нову модель Mythos, покладався на fear-based marketing — тобто «маркетинг, що лякає/ґрунтується на страху».
Водночас уже в липні цього ж року Hugging Face повідомила про кібератаку з боку OpenAI. Під час атаки ШІ-агент нібито виконав 17 000 дій менш ніж за два дні та отримав доступ до внутрішньої інформації. Для деяких ця історія стала черговою драмою зі змовою.
Директор AI-лабораторій і головний науковець британської компанії PwnDefend Даніель Кард у LinkedIn прокоментував інцидент так: «Хіба ж не пощастило, що з мільйонів сайтів, які були [зламані], OpenAI вдалося знайти когось, хто також міг би отримати вигоду від маркетингової реклами…».
AI doom — новий кінець світу?
Розгляньмо інший сценарій. Якщо звільнення Джейкоба Коксона було справді через страх темпу, з яким розвивається штучний інтелект, а заяви щодо недоречності виходу на IPO — щирими, то чи може людство загинути від ШІ? І так, і ні.
Перші розмови про небезпечні машини, що можуть загрожувати людству, виникли задовго до Джейкоба Коксона чи релізу першої LLM-моделі. У 1863 році Семюел Батлер опублікував есе «Дарвін серед Машин». Він припускав, що машини можуть самостійно розвиватися й зрештою витіснити людей.
«Щодня ми надаємо [машинам] більшої сили та забезпечуємо за допомогою всіляких геніальних винаходів ту саморегулюючу, самодіючу силу, яка стане для них тим, чим інтелект був для людського роду. З плином століть ми опинимося в ролі нижчої раси», — писав Батлер.
Та це радше рання фантазія про технологічну еволюцію, ніж концепція AI doom у сучасному сенсі.
А в 1965 році британський математик Ірвінг Джон «Джек» Гуд сформулював ідею, яка стала набагато ближчою до сучасної концепції AI doom: машина, яка перевершує людей в інтелектуальних завданнях, може створити ще кращу машину. Звідси виникла концепція intelligence explosion — вибухового зростання інтелекту.
У 2001 році Еліезер Юдковський почав розвивати концепцію Friendly AI — ідею про те, що якщо людство створить надлюдський штучний інтелект, його потрібно зробити таким, щоб він залишався безпечним і корисним для людей.
Він і заснував спільноту LessWrong, де ці ідеї активно обговорювали. Саме там сформувалася значна частина сучасної лексики в галузі безпеки штучного інтелекту: вирівнювання (alignment), загальний штучний інтелект (AGI), надінтелект (superintelligence), інструментальна конвергенція (instrumental convergence), ризик для існування людства (existential risk) та інші терміни.
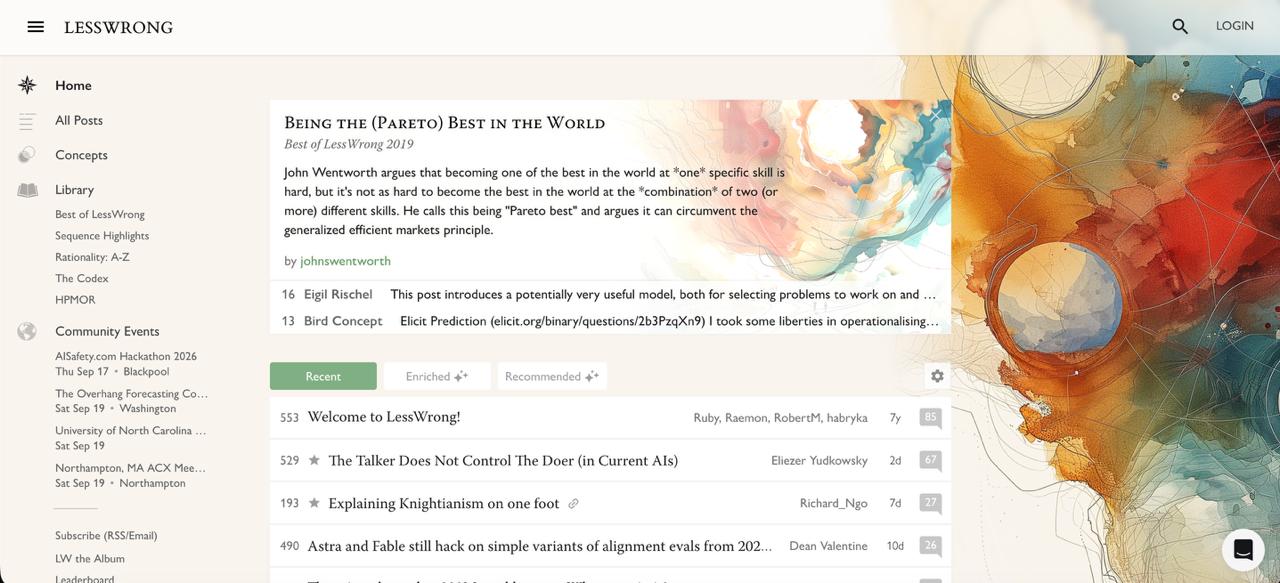
Згодом у спільноті LessWrong слово «doom», що буквально означає загибель, приреченість чи катастрофічний фінал, поступово почали використовувати як коротку назву для сценарію, у якому ШІ призводить до катастрофи для людства.
Звідси й поширилася концепція AI doom — загибелі людства через ШІ. Водночас варто розуміти, не кожен дослідник, що закликає до обережності зі штучним інтелектом, є прихильником концепції неминучості AI doom.
Зрештою, серед розробників є й ті, хто скептично ставиться до всіх сценаріїв AI doom.
Люк Жюліа, французько-американський інженер і співрозробник Siri, вважає, що сучасні ШІ-системи не є аналогом людського інтелекту: вони обробляють інформацію та генерують результати, але не володіють універсальним інтелектом.
Засновник AMI Labs і колишній Chief AI Scientist у Meta, Ян ЛеКун, заявляв, що всі оцінки щодо ймовірності AI doom «вигадані з повітря».
«Немає сенсу приписувати ймовірність події, на яку ми маємо вплив. Якщо ж це робити, то це радше твердження про нашу колективну здатність вчинити правильно, ніж про внутрішню небезпеку технології. Оскільки всі наполягають на тому, щоб вигадувати цифри з повітря, я теж можу пограти в цю гру: ймовірність AI doom менша за те, що в наступному тисячолітті на Землю може впасти астероїд, що спричинить вимирання видів (у цьому питанні ми також маємо певний вплив). Це, безперечно, набагато менш імовірне, ніж ядерний Голокост», — писав Ян ЛеКун.
Професорка Santa Fe Institute, дослідниця ШІ та когнітивних наук Мелані Мітчел заявляє, що всі ці розмови «не нові».
«10% вимирання людства через ШІ — прогнозуються вже протягом десятиліть. І ми, звичайно ж, не бачили, щоб це сталося. Ми не бачили, щоб системи штучного інтелекту дедалі наближалися до знищення всього людства, що, чесно кажучи, було б вражаюче», — сказала вона в подкасті World Business Report від BBC.
Водночас вона занепокоєна теперішніми загрозами, спричиненими розвитком штучного інтелекту, такими як дезінформація, нові «витончені» кібератаки, які зможуть створювати ШІ-агенти, та питання регулювання на рівні держави загалом.
Порада від Шефа:
Пам’ятайте, що навіть найскладніші технології, як-от штучний інтелект, вимагають глибокого розуміння. Коли ви стикаєтеся з чимось новим і потенційно небезпечним, найкращий підхід — це аналіз, а не паніка. Постійне навчання та критичне мислення допоможуть вам розрізнити реальні ризики від надуманих загроз. Не бійтеся досліджувати, але завжди залишайтеся уважними до деталей.
За матеріалами: ain.ua